Analista de Dados | Engenharia e BI

Pipelines no trabalho,
representação
na vida.

Construo pipelines, modelos analíticos e painéis que transformam dados brutos em decisão, com Python, SQL, PySpark e cloud (AWS e Azure).
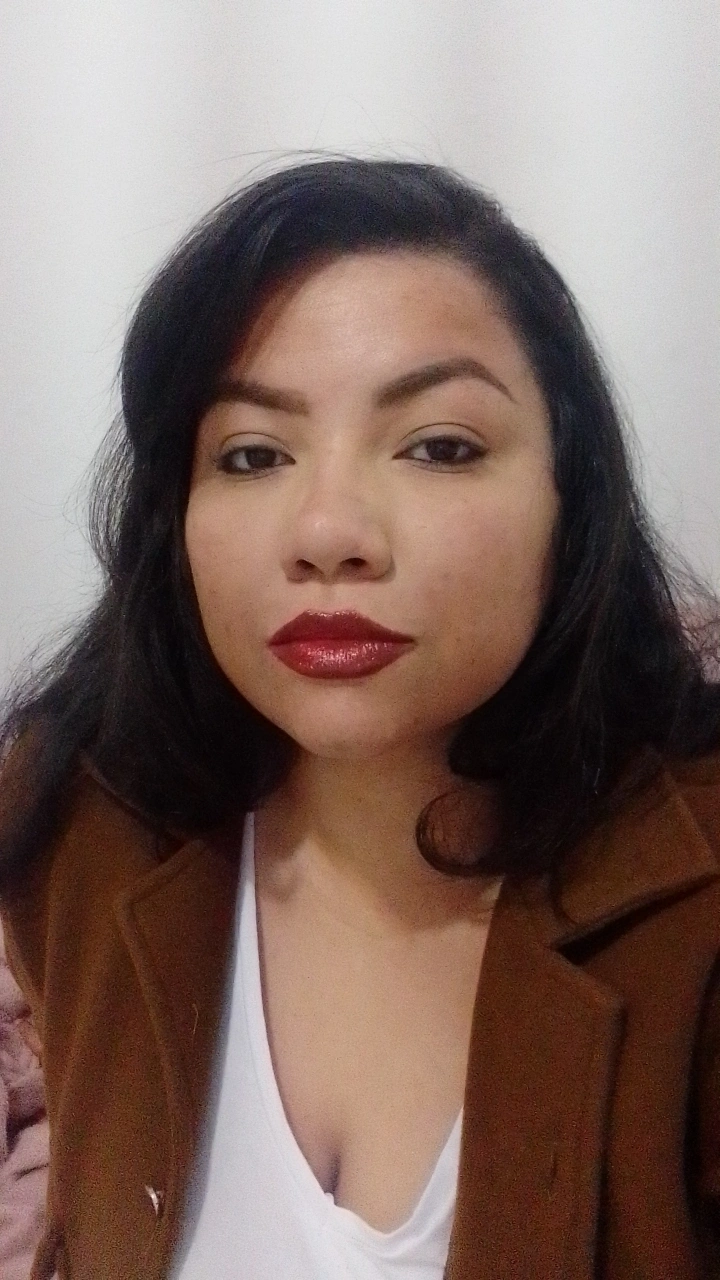
Suami Medeiros
100%
Integridade nos pipelines
Python · SQL · Apache Airflow · Docker · AWS · Azure · GCP · Databricks · ETL · Data Lake · Selenium · PostgreSQL · Pandas · Governança de Dados · Python · SQL · Apache Airflow · Docker · AWS · Azure · GCP · Databricks · ETL · Data Lake · Selenium · PostgreSQL · Pandas · Governança de Dados ·

Sobre mim

Dado confiável é infraestrutura de negócio.

Sou Analista de Dados com experiência em desenvolvimento, manutenção e otimização de pipelines, da ingestão e tratamento até a disponibilização das informações para BI e Analytics. Trabalho com Python, SQL, PySpark e Spark SQL, aplicando boas práticas para garantir qualidade, consistência e confiabilidade dos dados. Atuo hoje no Hospital Vera Cruz, em Campinas, onde desenvolvo painéis em Power BI integrando múltiplas fontes (Oracle, PostgreSQL, SQL Server, Excel, SharePoint e APIs), além de otimizar consultas e views para ganhar desempenho e governança. Também construo pipelines em nuvem (AWS e Azure Databricks) com Arquitetura Medalhão, orquestração com Airflow e Docker e modelagem de fatos e dimensões. Antes de dados, trabalhei com desenvolvimento mobile em Flutter, Firebase e APIs REST, o que me deu uma visão de produto que levo para cada solução que construo. Também explorei IA Generativa, com assistentes conversacionais usando RAG. Criadora da newsletter “Falando sobre Dados”. Certificada em Databricks Fundamentals.
100%
Integridade nos pipelines entregues
3
Clouds: AWS, Azure e GCP
91
Registros migrados com integridade total
12
Colunas estruturadas no dataset de scraping

Stack

Ferramentas que uso no dia a dia.

Do pipeline à nuvem, passando por dados e automação.

Linguagens
Python
SQL
Engenharia & Orquestração
Apache Airflow
Docker
dbt
Selenium
PostgreSQL
Cloud
AWS
Azure / Azure Data Factory
GCP / BigQuery
Databricks
Microsoft Fabric

Projetos

Dados em prática.

Projetos reais, documentados do problema ao resultado.

Engenharia de Dados
Pipeline ETL com Airflow e Docker

Pipeline automatizado que extrai, valida e carrega dados entre dois bancos PostgreSQL. Agendado diariamente, 100% reproduzível, com validação de integridade em 91 registros migrados.

AirflowDockerPostgreSQLPython
↗
Web Scraping
Scraping da Folha de Pagamento SP com Selenium

Scraper em Python com Selenium para extração de dados públicos da Prefeitura de São Paulo. Dataset com 12 colunas, limpeza completa e entregue com Docker para reprodutibilidade.

SeleniumPythonPandasDocker
↗

Conteúdo

No YouTube.

Jornada em dados, projetos reais, ferramentas e bastidores do dia a dia.

Ver canal no YouTube →

Escrita

Artigos sem filtro.

Sobre dados, carreira e aprendizados reais da minha jornada.

Ver todos os artigos →

Contato

Vamos conversar
sobre dados?

Aberta a oportunidades, colaborações e trocar ideia sobre tech e representatividade.